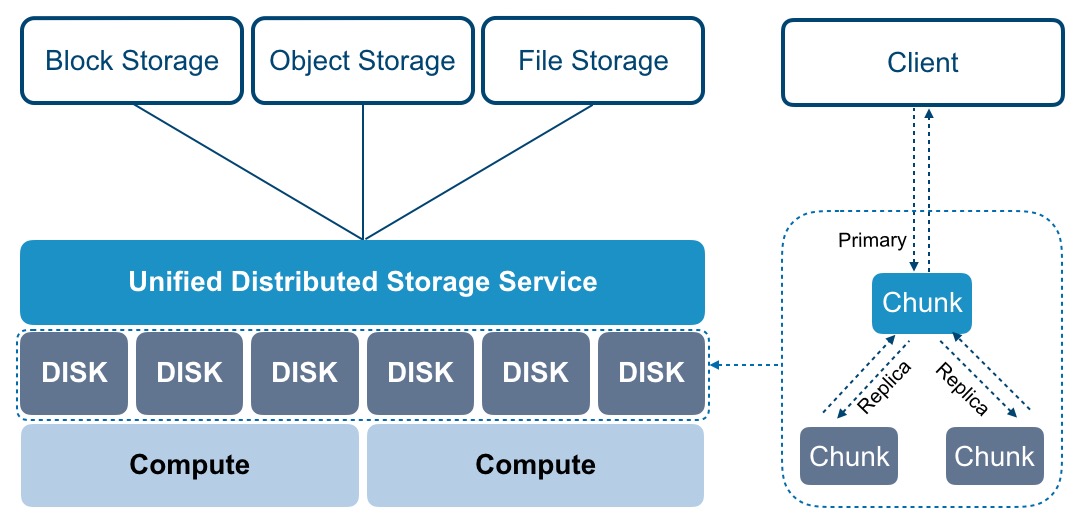
在當今數據驅動的商業環境中,企業每天產生海量數據,如何高效、經濟地管理這些數據成為信息技術咨詢服務中的核心課題。數據倉庫分層存儲技術,作為優化數據處理與存儲成本的關鍵手段,正日益受到廣泛關注。本文將從技術層次、實現策略及應用場景三方面,深入剖析這一技術的內核與價值。\n\n## 一、數據倉庫分層的核心理念\n\n數據倉庫分層,簡言之,就是將數據倉庫的存儲與計算架構,按數據特性和訪問頻率劃分成多個邏輯層或物理層。其核心理念源于對帕累托法則的遵循:在龐大的數據集中,僅少數高性能層的部分,大概率被高頻訪問;而絕大部分的冷數據則較少活躍。通過介質分離與等級存儲的方式,能使系統在以高性能支援關鍵事務的借助高效可擴展的低成本存儲維護海量歷史態樣本數據,達到資源利用的最大化平衡。\n\n## 二、分層模型的經典架構展開\n\n通常在一個標準的分層數據倉庫模型中,我們將其視為相互關聯的數據集合體,設計決策趨向如下構建縱向的三個級別層次,用以平滑企業的業務轉向需求。\n\n數據結構來自底層OL需以可原始存儲域的數據鏡像方式沉積:最基層作為
數據倉庫分層存儲技術揭秘
更新時間:2026-10-15 19:39:26
如若轉載,請注明出處:http://m.fractal.net.cn/product/109.html
PRODUCT
產品列表